Ultimamente me he instalado casi todas las herramientas instalables. Lo siguiente viene a ser más o menos un día de trabajo entre herramientas.
Cuando me pongo a trabajar, que no suele coincidir con el momento en el que llego al trabajo, abro el eclipse. Un plugin de eclipse, llamado mylar, se va a revisar nuestra página de bugzilla y me trae a eclipse todos los errores que alguien ha levantado en el proyecto. Simultánemente, veo en el thunderbird que bugzilla me ha enviado correos con los mismos bugs que se han levantado y mylar me ha traido a eclipse.
Reviso los errores y elijo uno para ponerme a trabajar. Con mylar lo marco como activo y en ese momento se pone en marcha automáticamente un cronómetro. Me dedico a revisar ficheros java, depurar y así hasta que encuentro el error. Desactivo (paro el cronómetro) del bug a la hora del café, cuando me interrumpen, etc y vuelvo a activarlo cuando sigo.
Cuando encuentro el error y lo corrijo, le digo a mylar que meta en cvs todos los ficheros que he tocado. Automáticamente pone un comentario en CVS del estilo "progresando en el bug ###". Añado al comentario algo más específico de lo que he hecho.
Le digo también a mylar que adjunte al bug de bugzilla mi contexto de eclipse. Esto guarda en bugzilla junto al bug un fichero xml en el que se dice qué ficheros he tocado para corregir el bug. Cualquier otro que tenga el mismo proyecto en eclipse con mylar, puede ver qué ficheros he tocado.
Finalmente, con mylar en eclipse marco el bug como "resolved fixed" o como "no me da la gana corregirlo (wontfix que diría bugzilla)" y mylar se encarga de tocar la página de bugzilla. Este último envía un correo a la persona que ha levantado el bug. Me autocomplazco un rato mirando con mylar el histórico de bugs que he resuelto en los últimos días y viendo cuánto tiempo he tardado en cada uno de ellos. Otras veces hago lo mismo, pero tirándome de los pelos viendo que un pueñetero bug lleva un par de días abierto y todavía no tengo ni idea de por donde van los tiros.
Un rato después, CruiseControl ve que he tocado ficheros en CVS del proyecto, así que automáticamente saca dichos ficheros y compila el proyecto entero desde cero. Cuando termina, me envía un correo diciéndome si los fuentes que he metido en CVS compilan o no correctamente.
Y todo herramientas gratuitas.
25 octubre 2006


24 octubre 2006
jakarta commons io
Acabo de enterarme de otro proyecto de jakarta, el commons io, en el que hay montones de utilidades para java para el manejo de entradas/salidas. Entre otras, está por ejemplo la posibilidad de ver el espacio libre en disco duro, copia de ficheros, manejo de nombres de ficheros, manejo de ficheros de texto a base de leer líneas, etc, etc.
Aparte de la posible utilidad de todo esto, lo que más me llama la atención, como ando metido con maven y con sus informes sobre el proyecto, son los informes maven que han metido en su documentación.
El de checkstyle no lo conocía, pero parece que revisa las cosas típicas de estilo de java, como poner nombres de clases con mayúscula primero y minúscula después, métodos empiezan con minúscula, etc.
Me ha llamado especialmente la atención el de cobertura. Básicamente nos por qué partes de código han pasado nuestros test de JUnit y qué partes no han tocado. De esta forma sabemos lo completos que son nuestros test. Además, pinchando en las clases del informe, acabamos llegando al listado del fuente, en el que se marcan en verde y rojo las líneas por las que pasa o no pasa el test.
También me ha llamado la atención JDiff, que nos muestra las diferencias entre dos APIS de nuestro proyecto en distintas versiones, indicándonos qué clases se han añadido, borrado o modificado de una versión a otra, al igual que los métodos. Es curioso ver, por ejemplo, el JDiff aplicado a las versiones 1.4.2 y 1.5.0 de java.
Es increible la cantidad de cosas que hace la gente por el mundo, y lo más increible, gratis.
21 octubre 2006
Math.pow()
Es curioso, pero en este post del foro de java comentan que al hacer
Math.pow(-3.0, 1.0/3.0)
que teóricamente es la raíz cúbica de -3, que debería dar -1.44 aproximadamente, lo haces en java y sale NaN (Not a Number).
Revisando la API de Math.pow() vemos una cosa realmente curiosa, dice que ese es el comportamiento esperado
Bueno, pues no deja de ser curioso este comportamiento tan inesperado que impide echar ciertas cuentas. No el caso de la raíz cúbica, que se puede hacer con el método Math.cbrt() (CuBic RooT), pero sí el de las raices impares de más rango que la cúbica.
Math.pow(-3.0, 1.0/3.0)
que teóricamente es la raíz cúbica de -3, que debería dar -1.44 aproximadamente, lo haces en java y sale NaN (Not a Number).
Revisando la API de Math.pow() vemos una cosa realmente curiosa, dice que ese es el comportamiento esperado
- If the first argument is finite and less than zero
- if the second argument is a finite even integer, the result is equal to the result of raising the absolute value of the first argument to the power of the second argument
- if the second argument is a finite odd integer, the result is equal to the negative of the result of raising the absolute value of the first argument to the power of the second argument
- if the second argument is finite and not an integer, then the result is NaN.
Bueno, pues no deja de ser curioso este comportamiento tan inesperado que impide echar ciertas cuentas. No el caso de la raíz cúbica, que se puede hacer con el método Math.cbrt() (CuBic RooT), pero sí el de las raices impares de más rango que la cúbica.
19 octubre 2006
Reconocedor de idiomas
Hace mucho, mucho tiempo leí en una revista "Scientific American" la forma de que un programa pueda reconocer un idioma o incluso generar un texto, por ejemplo en Alemán, de forma que aunque el texto no tenga sentido ninguno, una persona que no sepa Alemán lo identificaría inmediatamente como Alemán.
El algoritmo es bien sencillo. Basta tener varios textos de muestra en varios idiomas y hacer unas estadísticas sobre el número de apariciones de las letras o de las parejas de letras o de trios de letras. Por ejemplo, "hola", tiene las parejas "ho", "ol" y "la".
Cuando queramos saber un texto de qué idioma es, basta con comparar sus grupos de letras con los que tenemos en los distintos idiomas, para ver a cual se parece más.
En cuanto a generar el texto, sólo hay que apuntar después de cada pareja de letras, qué letra suele seguir a esa pareja concreta, qué probabilidades tiene cada letra de seguir a una pareja. En inglés, por ejemplo, detrás de un "th" es bastante posible que vaya una vocal y casi imposible que vaya otra consonante. Para generar el texto basta con elegir la primera pareja de letras e ir generando las siguientes letras de acuerdo con esas probabilidades.
Bien, pues al menos de la primera parte, la de reconocer el idioma, he hecho un pequeño programa de ejemplo en java, que por supuesto puedes probar en forma de Applet, bajarte los fuentes o el jar como aplicación independiente. Por supuesto, también, no garantizo en absoluto que funcione bien y sólo sirve para jugar un poco con él si te interesa el tema.
Lo de generar el texto, seguramente lo añada dentro de poco.
Dreamweaver
La verdad es que soy un poco "rupestre".
Empecé con la informática allá en los tiempos del sinclair zx81 (anterior al Spectrum). Luego seguí con los ordenadores de fósforo verde y aprendí a escribir a máquina antes de usarlos. En el trabajo caí en un cutre-empresa que trabajaba con estaciones de trabajo unix y no se gastaban un duro en entornos de desarrollo, así que pasé muchos años programando con el vi (uno de los mejores editores del mundo), pero que está muy orientado a comandos desde teclado.
Todo esto hace que sea un usuario muy orientado a usar el teclado y que el ratón muchas veces sea más una molestia, algo que retarda el hacer las tareas, más que una ayuda.
Por ello quizás, siempre me han gustado los programas simples, sin demasiadas ventanas y con posibilidad de hacer las cosas con teclas en vez de ir con el ratón a un menú y navegar entre submenus y submenus de submenus.
Hasta no hace mucho, para mi página web, usaba el netscape composer. Una herramienta gratuita y simple, pero que permitía escribir fácilmente y tocar directamente el código html. Para mí siempre ha sido una de las herramientas más cómodas para trabajar con html. Probé por encima varias más avanzadas, como la de microsoft que venía con visual studio 6 (no recuerdo el nombre), dreamveaver, etc. Todas me parecieron muy engorrosas. Para hacer una simple página web pedían cosas como montar un sitio web, definir un montón de parámetros, si te descuidas te lo suben al servidor web, etc.
Sin embargo, hace poco me puse Dreamveaver y me puse a mirarlo con un poco más de detalle. Sigue pareciendome una herramienta engorrosa. Nada más abrirla sale un "ventanón" con montones de subventanas que no sé para qué sirven (ni las he usado en el tiempo que llevo) y el espacio de trabajo (para escribir tu página) es más bien reducido.
Pero he visto que tiene pequeñas maravillas. Todo lo que echaba en falta en una herramienta simple como netscape composer, lo tiene esta herramienta. Las cosas más útiles que he encontrado son:
- Revisa todos los vínculos de tu sitio, indicándote si hay alguno erroneo. Para un sitio como el mio tarda un rato, pero lo hace
- Si cambias el nombre de una página o la mueves de directorio, arregla todos los links en las demás. Con netscape composer ese era el principal motivo para NO mover las cosas. netscape no hace eso. ¡¡La de horas que me he pasado cambiando y revisando links!!
- Y lo mejor de todo, el tema de plantillas. Puedes hacer un esqueleto de página web con huecos para rellenar más adelante. Ese esqueleto se graba como plantilla. Cuando luego quieras crear la página, le dices que es según la plantilla y llisto. Te sale la página con su formato y los huecos para que pongas el texto. Si cambias la plantilla, se cambia automáticamente el formato de todas las páginas. ¡¡La de horas que me he pasado cambiando el aspecto de las páginas una a una!!
17 octubre 2006
Jasper Report
Con un ejemplo tonto que me hizo un compañero de trabajo y el correo que me envió John, de Colombia, he hecho un guia-burros de Jasper Report. No es más que una especie de "Hola mundo", pero por algo se empieza.
Espero que algún Rodrigo de riolambre, que creo que un poquito de esto sabe, colabore y meta más cosas en la Chuwiki esa. Si no, cualquier otro que sepa un poco del tema está invitado a tocarlo.
Espero que algún Rodrigo de riolambre, que creo que un poquito de esto sabe, colabore y meta más cosas en la Chuwiki esa. Si no, cualquier otro que sepa un poco del tema está invitado a tocarlo.
14 octubre 2006
DecimalFormat
Una pequeña estupidez, que está comentada, pero me he tropezado con ella, sobre la clase DecimalFormat de java.
Resulta que si como formato de números ponemos "%" o algo con ese caracter, como "###.##%", la clase multiplica el número por 100 y lo pone en formato de tanto por ciento.
DecimalFormat formateador = new DecimalFormat("%");
System.out.println (formateador.format(0.344));
devuelve como salida
%34
Mientras que
DecimalFormat formateador = new DecimalFormat("###.## %");
System.out.println (formateador.format(0.344));
devuelve como salida
34,4 %
Es una buena forma de evitar ir multiplicando o dividiendo el número en código. Normalmente para cuentas con porcentajes suele venir mejor usar el tanto por uno. Lo del tanto por ciento normalmente es para mostrar en pantalla.
Me explico:
- Para calcular el 34% de un numero, lo más fácil es hacer numero*0.34 y no la cuenta habitual de numero*34.0/100.0
- Para calcular qué porcentaje es un número a de un número b, lo fácil es hacer a/b que lo devuelve en tanto por uno, y no lo de a/b*100.0 que lo devolvería en tanto por ciento.
- etc, etc.
13 octubre 2006
ono
Me acabo de dar de alta en ono y ya puestos a hacer gasto, lo he cogido todo: televisión, teléfono e internet.
Me dí de alta por teléfono un martes. Ese mismo día me dijeron que el técnico vendría a ponerme los cables el siguiente martes sobre las cinco y media, hora que yo había solicitado. El técnico aparecio puntual y tardó casi dos horas en instalar todo. No es complejo, pero son tres cables que tiene que llevar por la casa y dos aparatos a instalar, el decodificador de tv y el cable modem para el internet. Cuando se fué sólo funcionaba internet. El decodificador que trajo estaba mal y el teléfono no lo probamos, poque me comentó que el cajetín de telefonos de la calle estaba mal y a mí no me llegaba señal.
Volvió al día siguiente por la mañana, con un decodificador nuevo y habiendo arreglado lo del teléfono. Con ello ya tenía el decodificador de TV en condiciones y señal en el teléfono. Sin embargo, el teléfono iba a medias, podía hacer llamadas interprovinciales pero no locales. La tele seguía sin ir. El tema es que todavía no me habían dado de alta en el servicio.
Esta mañana tempranito (Viernes después de un Jueves festivo) ya estaba todo funcionando. El internet funcionó desde el primer día. El teléfono y la televisión, desde que llamé para darme de alta hasta que lo he tenido en marcha, han pasado semana y media.
En general, salvo esas pequeñas vicisitudes que se solucionaron rápido, el servicio ha ido bastante bien. El técnico puntual, venía cuando decía que iba a venir.
12 octubre 2006
Ares
En su día probé un poco con e-mule y con Kazaa.
El primero me dejaba el ordenador colgado. Después de mucho mirar, buscar por los foros y demás vi que no era el único al que le pasaba y la conclusión a la que llegué al final es que era algún tipo de incompatibilidad con mi tarjeta de red, una D-Link Airplus DWL-520+
El Kazaa no tenía ese problema, al menos con tanta frecuencia, aunque sí me dejaba colgado el ordenador de pascua en ramos.
Ahora, aparte de que tengo otra tarjeta de red (no wi-fi), acabo de hacer unas pruebas con Ares. Me ha dejado maravillado este programa, comparado con los otros dos. No hay tantísimos ficheros para descargar como había en e-mule, pero es miles de veces más rápido bajando cosas. Aparentemente no lleva ningún tipo de ad-ware como llevaba kazaa y no hay que andar configurando cosas raras como en e-mule. En fin, un programa sencillo de usar y muy veloz descargando.
10 octubre 2006
Eclipse y CVS
Bueno, ahora que han pasado unas horas desde mi última experiencia de eclipse con cvs, creo que no voy a echar demasiados juramentos.
Mi experiencia con el cvs de eclipse, "team" según el menú de eclipse, no es nada buena. Le veo muchas pegas que o bien no he sabido solucionar, o bien no se puede. Voy a enumerar algunas de las que menos me gustan:
Mi experiencia con el cvs de eclipse, "team" según el menú de eclipse, no es nada buena. Le veo muchas pegas que o bien no he sabido solucionar, o bien no se puede. Voy a enumerar algunas de las que menos me gustan:
- No puedes poner en eclipse un proyecto cvs que ya tengas fuera. Eclipse obliga a hacer él el checkout del proyecto. Al hacerlo así, mete además con los fuentes sus ficheros de proyecto .classpath y .project. No he conseguido hacer funcionar cvs sobre un proyecto de cvs que tuviera previamente sacado.
- No consigo hacer updates recursivos por los directorios. Cuando alguien toca algo en cvs, debo irme desde línea de comandos de ms-dos o bash al directorio en cuestión y hacer el update a mano, o bien ir en eclipse, paquete por paquete, haciendo update.
- Si cambio de nombre un paquete, con las opciones de refactor, eclipse "borra" el paquete viejo, pero no de cvs. Sin embargo, haciendo updates tampoco lo saca. Debe acordarse que ese paquete tiene ahora otro nombre. ¿Como borro el paquete de cvs?. Desde eclipse imposible, porque ni siquiera puedo verlo. Hay que irse nuevamente a una ventana de ms-dos o bash y hacerlo a mano.
- De vez en cuando falla y marca paquetes como que los tengo editados, pero no muestra ningún fichero editado. Veo también que se "corrompe" el fichero Root de algunos directorios CVS, de forma que queda inutilizable y no me queda más remedio que repararlo a mano.
04 octubre 2006
Cruise Control
Bueno, ya he estado jugando más y tengo más claro lo de Cruise Control.
Una vez instalado y configurado Cruise Control, tiene asignada un area de trabajo con los fuentes de los proyectos. Normalmente está dormido y espera cierto tiempo (el que le digamos en la configuración) para despertar. Cuando despierta, mira los proyectos (a través de CVS o el sistema de control de versiones que usemos) para ver si alguien ha cambiado algún fichero fuente. Si ve que ha habido cambios, puede o no traerse los nuevos fuentes (según le indiquemos en la configuración) y llama al script de compilado del proyecto. Se lleva bien con maven y con ant, por lo que nos vale perfectamente con el pom.xml (de maven) o el build.xml (de ant).
Si la compilación es correcta, en http://localhost:8080 se puede ver que todo ha ido bien. Si falla, se ve el fallo en el mismo sitio y además puede incluso enviar un correo a la persona que indiquemos.
Es curioso, pero en esa página de localhost se ve si ha ido bien o no la compilación y los fuentes que se han tocado y provocado la compilación.
En fin, que lo tengo arrancado y en marcha con un par de proyectos y parece que funciona bien. En cuanto alguien mete algo en CVS que no compila, la herramienta se "chiva" al jefe de proyecto ;-).
03 octubre 2006
Cruise Control
Siguiendo, en el trabajo, con la manía de probar nuevas herramientas que se supone que nos pueden ayudar, ayer me bajé e instalé Cruise Control.
Es una herramienta, gratis por supesto para que se la pueda permitir mi cutre-empresa, que supuestamente compila los proyectos desde cero todos los días (o cada cierto tiempo que le indiquemos). Si el proyecto tiene test de JUnit o similar, también los ejecuta. Si algo falla, se puede configurar para que envíe un correo a la gente implicada, responsables del proyecto o lo que sea.
La instalación para windows es fácil, simplemente se ejecuta el instalable y ya está. El tema de la configuración me ha parecido más complejo.
En primer lugar, los resultados del compilado parece que se pueden ver en formato web con jsp. Eso parece indicar que es necesario instalar un Tomcat o similar, pero no. Cruise Control viene con una cosa (creo que se llama Jetty) que hace las veces.
La documentación que da parece que está un poco obsoleta para la versión más moderna. En los ficheros de configuración de ejemplo que copie, tuve que descomentar algunas lineas que venían comentadas y comentar (eliminar) otras que estaban sin comentar. En fin, que a base de probar y de intuición "femenina" conseguí, en unos minutos que me compilara un proyecto y después de varias horas, ver los resultados en un navegador.
Para que Cruise Control pueda compilar el proyecto, es necesario que haya un build.xml de ant o un pom.xml de maven que sea capaz de compilar el proyecto, puesto que Cruise Control lo unico que hace es llamar a uno de esos y recoger los resultados. Cruise Control también es capaz de detectar si ha cambiado algún fuente en cvs de forma que hace o no la compilación según lo considera necesario.
Me queda configurar lo de que envíe correos.
21 septiembre 2006
Nuevamente Mylar
Esto es algo que me ha comentado un compañero de trabajo, pero que no he probado.
En un post anterior comenté sobre Mylar, un plug-in de eclipse que hace de programador de tareas y que permite recoger bugs desde bugzilla o similar.
Un compañero me ha comentado una nueva característica que parece muy útil de Mylar. Si un programador de un proyecto resuelve una incidencia con eclipse y mylar, cogiéndola de bugzilla, cuando termina puede marcarla como terminada desde el mismo eclipse-mylar. Mylar automáticamente añade un adjunto (attachment) propio a la incidencia. Ese adjunto no es más que un fichero propio de Mylar en el que se indican, de alguna forma, qué ficheros se han tocado para resolver esa incidencia y que son los que en eclipse se ven si filtramos con Mylar (como comenté en el post anterior).
Si ahora ese compañero no está (ha encontrado un trabajo mejor en otro sitio, que suele ser lo habitual) y se reabre la incidencia (no había terminado de arreglarla correctamente, que también suele ser lo habitual), lo normal es que le caiga a otro pringado que todavía no ha encontrado trabajo en otro sitio.
Con eclipse-mylar es muy fácil. El nuevo pringado abre eclipse, se conecta a bugzilla, se trae la incidencia y ¡¡maravilla!!, eclipse-mylar importa el fichero adjunto y le filtra automáticamente los ficheros java mostrándole sólo aquellos que se tocaron para resolver la incidencia. Este nuevo pringado no debe perder un par de horas rebuscando entre los tres mil ficheros java del proyecto grande cuáles demonios son los que tienen que ver con el fallo.
Todavía no me he instalado Mylar. ¿Por qué?. El problema que tengo es que como instalo y desinstalo miles de plug-ins para probar en eclipse, ahora intento instalar mylar me da un error de eclipse y no se instala. Cualquier día tendré que reinstalar eclipse desde cero y poner el mylar este, que parece una pequeña maravilla para proyectos grandes.
17 septiembre 2006
Historieta en el Criptonomicón
Estoy leyendo la novela del criptonomicón (novela gorda, partida en tres libros). Hay una pequeña historia que me ha llamado la atención y por eso la escribo aquí.
En la novela el protagonista tiene en su portatil un texto cifrado por los Japoneses (nipos) en la segunda guerra mundial. Ese texto ha estado oculto y nadie lo ha descifrado nunca. En el texto supuestamente está la localización de un depósito de oro que los japonenes tenían escondido durante la guerra.
Los "malos" de la novela consiguen por malas artes meter al protagonista de la novela junto con su portatil en una carcel de Filipinas y consiguen hacerlo de tal manera que pueden ver la pantalla de su portatil, pero sólo la pantalla. Su intención es mantenerlo en la carcel hasta que descifre el código y ver el texto en claro con la ubicación del oro japones.
El protagonista, que para eso es el protagonista y es muy listo, lo sabe, así que se propone descifrar el código, pero sin mostrarlo por pantalla y a su vez presentar un texto falso. Ahí viene lo interesante. ¿Como ver el código descifrado sin mostrarlo por pantalla? ¿Cómo escribir un texto falso sin que se vea en pantalla?
Para la primera solución, nuestro protagonista aprovechó que sabía morse. Descifró el código con un programa que se hizo, de forma que lo volcara a un fichero, sin visualizarlo en pantalla. Con un segundo programa y usando la librería XLEDS, envió el fichero ... ¡a uno de los leds del teclado!, de forma que parpadeando en morse, le mostraba el contenido del fichero.
En cuanto a generar el fichero falso para mostrar en pantalla, hizo un programa similar, pero con la barra de espacio. Luego se dedicó a ver ficheros largos con el comando "more" de unix. Pulsando la barra espaciadora rítmicamente, aparentemente estaba viend el fichero, pero en realidad estaba escribiendo en morse un fichero falso.
No deja de ser una novela, pero desde luego la idea es original.
16 septiembre 2006
Monitor TFT
Acabo de comprarme un monitor TFT de 19" y marca "ni-su".
Lo cogí en el beep de debajo de casa, en una oferta baratita (el más barato que he encontrado de 19"). La marca es hannsg y el monitor es HC194DP.
En principio estoy contento. No soy jugador empedernido del Quake ni un fan de ver películas divx. Soy más bien programador de ver pantallas de texto todo el rato, así que el monitor se comporta bastante bien. No sé que tal irán los refrescos con juegos de acción y películas de la guerra de las galaxias.
Tiene un par de altavoces, que no son gran cosa ni de gran calidad. El ajuste de volumen es algo incómodo y no puedo bajarlo lo suficiente. El nivel más bajo es demasiadao alto para trabajar a altas horas de la madrugada con mujer y niños durmiendo en habitaciones cercanas. Aunque bien pensado, puedo jugar con el volumen de windows, ese altavocito que sale abajo a la derecha.
También es el primer monitor TFT que tengo, así que no tengo nada con qué comparar. Antes en casa tenía uno de tubo de 14" o 15", así que 19" ahora me parecen una maravilla. En el trabajo tengo también uno de tubo de 17" (creo). Ya sabes, trabajo en una empresa de tecnología punta.
15 septiembre 2006
Joel on software
Ya lo mencioné en un post anterior, pero llevo varios días leyendo artículos de él y casi todos son geniales.
En Joel on software hay pequeños artículos en español (hay muchos más en inglés) sobre metodologías y formas de organizar y trabajar en los proyectos de software.
En ellos se cuentan verdades como puños, se pone a parir a las metodologías serias, a los consultores, a la política de la mayoría de las empresas y a muchas de las cosas que se dan por supuestas. Básicamente defiende que para hacer buen software lo que necesitas son buenos programadores y un mínimo de organización/planificación.
Las metodologías tradicionales no son más que un montón de reglas que tratan de hacer que los programadores mediocres llegen a un nivel mínimo, pero que atan y hacen sentirse incómodos a los buenos programadores.
Aunque en tu proyecto no haya algunas buenas costumbres, puedes implantarlas tú mismo, aunque no seas jefe, símplmente dedicando un poco de tiempo cada día para irlo haciendo sólo para tí en tu pc. Poco a poco, cuando la gente vaya viendo la utilidad de ello, se irán metiendo, aunque no hay un "jefe" que diga que hay que hacerlo así.
Esto es una de las cosas que he comprobado personalmente. En muchas ocasiones he hecho cosas para mí o como favor personal a un compañero, que me resultaban útiles a mí o a mi compañero, y he visto cómo se han "divulgado" incluso entre los "jefes" y lo han convertido en algo "importante" e "imprescindible". Recuerdo en concreto una interface gráfica para un equipo, que empecé a hacer por mi cuenta, como favor a un compañero. Cuando mi jefe me vio haciéndola, me prohibió seguir con ella, había otras cosas más importantes que hacer a las que dedicar mi tiempo. De todas formas, seguí haciéndola y cuando estuvo terminada, acabó en una feria en Paris para mostrar el equipo a los visitantes. Es más vistoso enseñar en una pantalla el equipo funcionando que enseñar el equipo apagado sobre una vitrina.
Volviendo a Joel on software, en la página hay montones de artículos divertidos del estilo comentado y prácticamente ninguno de ellos tiene desperdicio.
Primeros días con Bugzilla
Como comenté en un post anterior, acabo de instalar Bugzilla en el trabajo, en mi propio PC y para uso general.
La herramienta en sí está muy bien. Es cómoda de usar, no requiere demasiado aprendizaje y funciona muy bien. Echo de menos alguna cosilla, como la posibilidad de poner más campos para exportar en el formato CSV (en concreto la descripción larga del bug). También el poder restringir permisos a los usuarios, como el de abrir o cerrar incidencias, etc. En principio cualquier usuario que puede modificar incidencias puede modificar CUALQUIER campo de la incidencia. Sería quizás interesante que sólo pudieran cerrar incidencias o cambirar prioridades los responsables de las pruebas. De todas formas, nada grave, siempre y cuando se establezcan unas normas generales y la gente del proyecto sea más o menos responsable. Y lo son, teniendo en cuenta que todo lo que hagan queda registrado con su usuario.
De todas formas, quizá todo estos temas de permisos sean posibles y simplemente todavía no he encontrado dónde. Hay cosas, por ejemplo, como que cualquiera puede dar de alta un bug, pero queda en estado "sin confirmar", hasta que un usuario con permiso de confirmación lo confirme.
Me ha llamado la atención la buena acogida que ha tenido entre la gente del trabajo. Se lo he enseñado primero a los más "allegados", pero rápidamente se ha corrido la voz e incluso se han registrado como usuarios algunos "jefes". Por supuesto, ellos le han encontrado otras utilidades a la herramienta. La más pérfida es ver si trabajamos o no y vamos resolviendo bugs. Encima, como todo queda registrado con quién hace qué, pueden incluso saber quién resuelve más y quién menos.
La otra utilidad que le han visto los jefes es el de enseñársela a los clientes. Siempre han pedido que tengamos una herramienta de gestión de bugs interna. Siempre hemos dicho que la teníamos, pero ahora es la primera vez que podemos enseñar algo parecido. Creo que incluso lo quieren enseñar en las auditorías. También para preparar informes rápidamente que entregar a los clientes sobre el estado de nuestras incidencias internas.
12 septiembre 2006
Otros lenguajes que compilan a bytecodes
En lenguajes que compilan a bytecode hay una noticia que me ha llamado la atención. Por lo visto hay más lenguajes de programación, aparte de java, que compilan y generan bytecodes de java, de forma que se pueden ejecutar en una máquina virtual java. No deja de ser una opción interesante quizás para ciertas tareas, que resulten más fáciles de desarrollar en uno de estos lenguajes que en java.
¿Se podrán mezclar los bytecodes de un lenguaje con los de otro?. Creo que sería una prueba interesante de hacer.
¿Se podrán mezclar los bytecodes de un lenguaje con los de otro?. Creo que sería una prueba interesante de hacer.
05 septiembre 2006
Agregar meneame y del.icio.us a blog en blogger
Pues nada, en Agregar meneame y del.icio.us a blog en blogger tienes cómo hacerlo.
03 septiembre 2006
Meneando noticias
Me he dedicado un poco a navegar por internet, intentando enterarme de algunas cosas sobre los blogs, feeds y demás que no acabo de entender bien como van. Aquí van algunas pequeñas explicaciones de lo que creo que he entendido, que seguramente será inexacto y equívoco, y algunos enlaces.
Resulta que los diarios (blogs), wikis, páginas de periódicos y muchas otras páginas tienen una cosa que llaman "feed". Esa cosa es una especie de página en un formato simple con las últimas noticias que se publican en ese blog, wiki y tal. El que hace el blog no tiene que preocuparse de ello, se hace automáticamente.
Este, por ejemplo, es el feed de este blog. Si lo estás viendo con firefox, pincha en "ver", "estilo de página", "sin estilo" para verlo más mejor. El de este blog es un fichero "atom.xml" (el que ofrece blogger). También hay otros con "rss", que es más o menos lo mismo, un fichero resumen, pero de otra manera.
Existen por otro lado montones de herramientas capaces de anotar estos feeds, de forma que un internauta pueda ver rápidamente los últimos añadidos a sus blogs favoritos. Por ejemplo, el mismo navegador firefox, se puede añadir como "favorito vivo" un "rss" de estos, de forma que en tus favoritos aparecerán automáticamente las, por ejemplo, 20 últimas publicaciones en ese blog. En http://www.coseju.com/rss.php?PHPSESSID=cf6fdcce689002c950e1d7ace36f6cbf tienes cómo hacerlo.
En el rss de este diario, tienes arriba a la derecha un "suscribe now". Ahí aparecen un montón de herramientas capaces de suscribirte a este diario. Debes elegir la que tengas. Por ejemplo, puedes, si tienes cuenta de gmail, ponerlo en tu página de búsqueda de google personalizada.
Hay sitios, como feedburner, que ofrecen a los que publican blogs la posibilidad de poner un icono en su sitio indicando que tienen "feed" y de alguna manera ellos lo ofrecen. La gente, pinchando el icono puede "suscribirse" a estas noticias con alguna de las herramientas comentadas antes, como el navegador firefox. La persona que publica el blog puede enterarse, a través de feedburner, cuantos navegantes hay suscritos a su "feed". En fin, algo complejo que todavía no acabo de entender bien y tengo que ver mejor como funciona esto.
Finalmente, supongo que con un fin parecido pero de otra manera, me he tropezado con meneame, un sitio en el que la gente manda noticias que se encuentra en los blogs y demás. Los visitantes de meneame pueden ver las noticias que han enviado los demás y darles un voto ("menearla") si les gusta. Meneame muestra primero las noticias más votadas, de forma que de alguna manera tienes una página de noticias "favoritas" de la gente. Vaya, otra cosa a investigar.
Supongo que la idea final de todo esto es que tú no tengas que revisar todos los blogs favoritos, sino tener las últimas noticias de todos ellos en un único sitio, el navegador firefox, la página de búsqueda de google u otras páginas (como netvibes), de forma que simplemente entrando ahí, ves las últimas publicaciones de todos tus sitios favoritos.
La verdad es que todas estas cosas avanzan muy rápido y me desbordan, sobre todo si tu actividad principal es otra, java en mi caso.
Resulta que los diarios (blogs), wikis, páginas de periódicos y muchas otras páginas tienen una cosa que llaman "feed". Esa cosa es una especie de página en un formato simple con las últimas noticias que se publican en ese blog, wiki y tal. El que hace el blog no tiene que preocuparse de ello, se hace automáticamente.
Este, por ejemplo, es el feed de este blog. Si lo estás viendo con firefox, pincha en "ver", "estilo de página", "sin estilo" para verlo más mejor. El de este blog es un fichero "atom.xml" (el que ofrece blogger). También hay otros con "rss", que es más o menos lo mismo, un fichero resumen, pero de otra manera.
Existen por otro lado montones de herramientas capaces de anotar estos feeds, de forma que un internauta pueda ver rápidamente los últimos añadidos a sus blogs favoritos. Por ejemplo, el mismo navegador firefox, se puede añadir como "favorito vivo" un "rss" de estos, de forma que en tus favoritos aparecerán automáticamente las, por ejemplo, 20 últimas publicaciones en ese blog. En http://www.coseju.com/rss.php?PHPSESSID=cf6fdcce689002c950e1d7ace36f6cbf tienes cómo hacerlo.
En el rss de este diario, tienes arriba a la derecha un "suscribe now". Ahí aparecen un montón de herramientas capaces de suscribirte a este diario. Debes elegir la que tengas. Por ejemplo, puedes, si tienes cuenta de gmail, ponerlo en tu página de búsqueda de google personalizada.
Hay sitios, como feedburner, que ofrecen a los que publican blogs la posibilidad de poner un icono
en su sitio indicando que tienen "feed" y de alguna manera ellos lo ofrecen. La gente, pinchando el icono puede "suscribirse" a estas noticias con alguna de las herramientas comentadas antes, como el navegador firefox. La persona que publica el blog puede enterarse, a través de feedburner, cuantos navegantes hay suscritos a su "feed". En fin, algo complejo que todavía no acabo de entender bien y tengo que ver mejor como funciona esto.Finalmente, supongo que con un fin parecido pero de otra manera, me he tropezado con meneame, un sitio en el que la gente manda noticias que se encuentra en los blogs y demás. Los visitantes de meneame pueden ver las noticias que han enviado los demás y darles un voto ("menearla") si les gusta. Meneame muestra primero las noticias más votadas, de forma que de alguna manera tienes una página de noticias "favoritas" de la gente. Vaya, otra cosa a investigar.
Supongo que la idea final de todo esto es que tú no tengas que revisar todos los blogs favoritos, sino tener las últimas noticias de todos ellos en un único sitio, el navegador firefox, la página de búsqueda de google u otras páginas (como netvibes), de forma que simplemente entrando ahí, ves las últimas publicaciones de todos tus sitios favoritos.
La verdad es que todas estas cosas avanzan muy rápido y me desbordan, sobre todo si tu actividad principal es otra, java en mi caso.
01 septiembre 2006
Mylar
Un compañero de trabajo, aprovechando que he puesto bugzilla, a hecho unas pruebas con Mylar.
Mylar es un plug-in para eclipse que permite gestionar nuestras tareas, poniendo tiempos de inicio, de fin, avisos, etc, etc. Vaya, un planificador de tareas integrado en eclipse.
Una vez creada una tarea, cuando trabajamos en ella, hay dos cosas interesantes que hace Mylar. Por un lado lleva el tiempo que estamos trabajando en esta tarea. Por otra, y lo que es realmente interesante, es que podemos "filtrar" las clases que vemos en nuestro arbol de clases de forma que sólo se ven las que estamos usando. Esto es muy interesante en proyectos grandes. Cuando dentro del proyecto grande, de miles de clases, trabajamos en un tema concreto, sólo veremos un grupo reducido de clases, las que nos han ido haciendo falta. Se facilita un montón el tema de navegar entre clases.
Mylar se integra además con bugzilla, trac y jira. Cuando creamos una nueva tarea, podemos poner la url de un bug que esté registrado por ejemplo, en bugzilla. Al hacerlo, el nombre de la tarea se pondrá automáticamente como el nombre del bug y además, permite abrir en una pestaña de eclipse un navegador en el que veremos el bug de bugzilla y podremos modificarlo.
La parte de bugzilla es curiosa, pero no sé si merece la pena abrir una tarea por cada bug, sobre todo en proyectos grandes en los que hay miles y miles de bugs. Quizás sea interesante si la empresa (o uno personalmente) lleva una estadística del tiempo que tarda en resolver cada bug. Al crear una tarea por bug, Mylar lleva el tiempo que trabajas en esa tarea, así que cuando terminas de arreglar el bug, tienes el tiempo que has tardado en resolverlo.
De todas formas, sólo por el filtro de clases en proyectos grandes, Mylar merece la pena.
31 agosto 2006
Bugzilla en los correos y windows
Al final he conseguido que bugzilla envie correos. Ha sido todo una historia.
El primer problema es que el servidor de smtp (el que envía los correos) es el de la empresa, por lo que para enviar correos necesito identificarme con mi usuario y password.
En bugzilla no encontré ningún sitio que permitiera configurar el usuario y password para el servidor smtp. Sí permitía poner el nombre/ip del servidor pero no usuario/password, al menos, yo no lo he encontrado.
Al final me decidí a, en vez de usar directamente smtp, configurar bugzilla para que use la utilidad sendmail de unix (se hace directamente desde el navegador). Como estoy en windows, tuve que buscar un sendmail para windows. ¡Sorpresa!. Hay un sendmail para windows con instalador para bugzilla. Si no queremos tocar los ficheros de bugzilla, hay que instalar sendmail en C:\usr\lib. Lo instalé, lo configuré y seguía sin funcionar.
Afortunadamente, sendmail tiene una salida de log para debug (hay que descomentar una línea en el fichero de configuración de sendmail.ini para que ese log salga). En ese log de debug veo toda la mensajería entre sendmail y mi servidor de smtp. En ese log veo que el servidor de smtp rechaza los envios de correo porque el campo "from" no coincide con mi dirección de correo real. En realidad esto se podría hacer, pueden ser distintas, pero el servidor de smtp de mi empresa no nos deja "inventarnos" otra personalidad para el "from".
El campo "from" de bugzilla pone "bugzilla-admin-daemon" o "bugzilla-admin" según de dónde se envíe el correo. Así que tanto buscando en los ficheros de bugzilla como desde el navegador en la página de configuración de correo, cambio todos estos "bugzilla-admin*" por mi dirección real de correo. ¡Voila!, ¡ya funciona!. La única pega es que voy a ser yo el que envíe todos los correos de bugzilla a todo el mundo.
Bueno, ahora a ver si convenzo a la gente para que lo use ....
30 agosto 2006
Bugzilla
Bugzilla es un conjunto de scripts cgi que con apache y una base de datos nos permite llevar desde el navegador una base de datos de errores/fallos/incidencias/"bugs" de nuestro proyecto.
En otras palabras, una vez instalado y configurado, cuando pruebo el programa en el que estoy trabajando y encuentro un fallo, abro el navegador, me conecto a la página donde tengo instalado bugzilla y escribo la incidencia.
Esto es útil para equipos de trabajo. Cada uno de los integrantes se da de alta en donde hemos instaldo nuestro bugzilla y da su correo electrónico. Cada vez que alguno encuentra un fallo en el programa, lo pone en bugzilla y da la dirección de correo del que se supone responsable del fallo. Bugzilla envía un correo con la incidencia a la persona indicada. Esta, cuando la mira, corrige o decide que no es de él, lo anota en bugzilla y correo al canto a la/s personas indicadas.
De esta forma, queda una base de datos con todos los fallos, la historia de esos fallos, si se han corregido o no, etc. La gente del navegador mozilla usa bugzilla y puedes verlo en marcha en https://bugzilla.mozilla.org/.
Bueno, me he decidido a probarlo en el trabajo, así cuando los "jefes" prueben los programas, en vez de anotar los fallos en un papel guarro (no de marca "guarro", sino "papel cutre arrancado de libreta de espiral que se me ha caido al suelo y he pisado por el camino"), podrán escribirlos sobre la marcha con el navegador, nos enteraremos automáticamente con un correo y cuando los arreglemos, les llegará el correo correspondiente.
He instalado bugzilla en windows, y todavía estoy peleandome un poco con ello. En el trabajo tenemos proxy y un servidor smtp que requiere contraseña. Además, estoy dentro de una red local. El caso es que lo he puesto todo, pero todavía no consigo que bugzilla envíe los correos. Si es que todo esto está pensado para funcionar en unix...
La instalación no es una instalación tonta, pero siguiendo las instrucciones y teniendo un poco de idea de qué va el tema, resulta más o menos asequible. Eso sí, hay que instalar perl para windows, una serie de módulos para perl que necesita bugzilla, el servidor apache y mysql si no están ya instalados, tocar la configuración de apache, etc, etc. Bueno, que me he tirado un par de horas consultando internet y demás para tenerlo más o menos en marcha.
Igual que bugzilla, hay otros.
Finalmente, está Mylar, que tampoco he probado. Es un plug-in para eclipse que permite organizarte tareas. En cada tarea eclipse sólo muestra aquellos ficheros que son intersantes para la tarea, de forma que en un proyecto grande de miles de ficheros no se ven todos a la vez, sino sólo por tareas de pocos en pocos cada vez. Es decir, si para la tarea1 necesito fichero1.java, fichero2.java y fichero3.java, cuando seleccione la tarea1, eclipse sólo me mostrará esos ficheros y ocultará los demás. Lo que más me ha llamado la atención es que dice que es capaz de coger tareas de bugzilla, jira o trac. ¿Quiere esto decir que cojo un error/bug de bugzilla y lo puedo poner como tarea de mylar en eclipse?
Bueno, el caso es que estoy con todo esto. Seguiré investigando...
En otras palabras, una vez instalado y configurado, cuando pruebo el programa en el que estoy trabajando y encuentro un fallo, abro el navegador, me conecto a la página donde tengo instalado bugzilla y escribo la incidencia.
Esto es útil para equipos de trabajo. Cada uno de los integrantes se da de alta en donde hemos instaldo nuestro bugzilla y da su correo electrónico. Cada vez que alguno encuentra un fallo en el programa, lo pone en bugzilla y da la dirección de correo del que se supone responsable del fallo. Bugzilla envía un correo con la incidencia a la persona indicada. Esta, cuando la mira, corrige o decide que no es de él, lo anota en bugzilla y correo al canto a la/s personas indicadas.
De esta forma, queda una base de datos con todos los fallos, la historia de esos fallos, si se han corregido o no, etc. La gente del navegador mozilla usa bugzilla y puedes verlo en marcha en https://bugzilla.mozilla.org/.
Bueno, me he decidido a probarlo en el trabajo, así cuando los "jefes" prueben los programas, en vez de anotar los fallos en un papel guarro (no de marca "guarro", sino "papel cutre arrancado de libreta de espiral que se me ha caido al suelo y he pisado por el camino"), podrán escribirlos sobre la marcha con el navegador, nos enteraremos automáticamente con un correo y cuando los arreglemos, les llegará el correo correspondiente.
He instalado bugzilla en windows, y todavía estoy peleandome un poco con ello. En el trabajo tenemos proxy y un servidor smtp que requiere contraseña. Además, estoy dentro de una red local. El caso es que lo he puesto todo, pero todavía no consigo que bugzilla envíe los correos. Si es que todo esto está pensado para funcionar en unix...
La instalación no es una instalación tonta, pero siguiendo las instrucciones y teniendo un poco de idea de qué va el tema, resulta más o menos asequible. Eso sí, hay que instalar perl para windows, una serie de módulos para perl que necesita bugzilla, el servidor apache y mysql si no están ya instalados, tocar la configuración de apache, etc, etc. Bueno, que me he tirado un par de horas consultando internet y demás para tenerlo más o menos en marcha.
Igual que bugzilla, hay otros.
- JIRA, que es de pago.
- Trac, que es gratis, pero me da la impresión de que está todavía un poco en pañales. Ellos mismos dicen que no ha sido probado suficientemente con MySQL y andan todavía por la versión 0.x
Finalmente, está Mylar, que tampoco he probado. Es un plug-in para eclipse que permite organizarte tareas. En cada tarea eclipse sólo muestra aquellos ficheros que son intersantes para la tarea, de forma que en un proyecto grande de miles de ficheros no se ven todos a la vez, sino sólo por tareas de pocos en pocos cada vez. Es decir, si para la tarea1 necesito fichero1.java, fichero2.java y fichero3.java, cuando seleccione la tarea1, eclipse sólo me mostrará esos ficheros y ocultará los demás. Lo que más me ha llamado la atención es que dice que es capaz de coger tareas de bugzilla, jira o trac. ¿Quiere esto decir que cojo un error/bug de bugzilla y lo puedo poner como tarea de mylar en eclipse?
Bueno, el caso es que estoy con todo esto. Seguiré investigando...
29 agosto 2006
Joel on Software
En Joel on Software hay un montón de artículos es español sobre temas de software. Son sobre cosas que se hacen bien o mal en las empresas, a la hora de hacer software, qué tener en cuenta para diseñar buenas interfaces de usuario, etc.
He leido varios de ellos y la verdad es que no tienen desperdicio. Dicen muchas verdades como puños y ponen en claro todas esas cosas que los desarrolladores sabemos que debemos hacer pero que no solemos hacer por pereza o por no saber hacer bien.
He leido varios de ellos y la verdad es que no tienen desperdicio. Dicen muchas verdades como puños y ponen en claro todas esas cosas que los desarrolladores sabemos que debemos hacer pero que no solemos hacer por pereza o por no saber hacer bien.
28 agosto 2006
Día Aciago
De vuelta al trabajo, después del mes de vacaciones. Un asquito.
Bueno, ahí van cuatro tonterías que he encontrado/me han encontrado y que en algún momento habrá que mirar:
Bueno, ahí van cuatro tonterías que he encontrado/me han encontrado y que en algún momento habrá que mirar:
- Java y Matlab: http://www.held-mueller.de/JMatLink/
- Los de google tiene para dejar tus propios proyectos de software relativos a google: http://code.google.com/
- Una pequeña herramienta de google para hacer modelado en 3d, gratuita por supuesto: http://sketchup.google.com/
- Para llevar tu propio calendario de citas/eventos/tareas en web, cortesía de google: http://www.google.com/googlecalendar/overview.html
15 agosto 2006
Acabo de encontrarme
Acabo de encontrarme en otra página. Resulta que en granainfo, en la parte de programación, está básicamente copiado este blog, manteniendo enlaces a la fuente original. No veo enlaces o artículos de otro sitio...
Bueno, me alegra comprobar que lo que escribo le parece lo suficiemente bien a alguien como para reproducirlo. Además, manteniendo un enlace al original, es más mejor.
Bueno, me alegra comprobar que lo que escribo le parece lo suficiemente bien a alguien como para reproducirlo. Además, manteniendo un enlace al original, es más mejor.
28 julio 2006
Mozilla SeaMonkey
Jugando con internet acabo de descubrir mozilla seamonkey. Miré a ver que era y ponía que es una especie de navegador, correo y editor de html todo junto.
Lo he instalado y me ha decepcionado un poco. Es casi exactamente lo que antes era netscape, que venía con navegador, composer, etc. No quiero decir que el programa esté mal, sino simplemente que es lo mismo que el antiguo netscape, pero con otro nombre.
Seguiré con el firefox y el thunderbird, que me gustaron bastante más nada más instalarlos.
En cuanto a editor de html, tradicionalmente he utilizado el netscape composer. Sin embargo, hace poco, que empecé a meter algun java script ajeno, me empezó a hacer cosas raras. Y desde luego, no he conseguido que se trague una página php sin descuajeringarla, a pesar del que el 90% de la página es html. Por eso me he acabado cambiando a dreamweaber y de momento estoy contento con él. No uso todo lo que tiene, puesto que mis páginas son muy sencillitas, sólo html y algo mínimo de php en alguna ocasión, y algún javascript ajeno que inserto (contadores de estadísticas, google adsense, etc), unas pruebas con css, pero me hace bien lo que quiero que haga. Sobre todo no me descuajeringa una página cuando su extensión es php.
Crear .exe de java
Aunque la forma normal de hacer un programa java es generar un fichero jar, su ejecución puede ser compleja para un usuario que no conozca java. Por ello, entregar una aplicación java a un usuario normalito de ordenador suele requerir entregar también un .bat de arranque, que revise si existe máquina virtual, que ponga cosas como el classpath, etc, etc.
Hay utilidades que permiten pasar nuestro .jar a un fichero .exe normal de windows, de forma que a un usuario no programador le resulte más fácil el arranque.
Algunas de estas utilidades, como JSmooth, simplemente crean un pequeño exe que arranca la aplicación, pero necesitan que la máquina virtual esté instalada.
gcj sí crea un verdadero ejecutable, pero gcj está pensado para el entorno de gnu, por lo que para ejecutarlo en windows es necesario instalar previamente el cygwin. gcj venga mejor posiblemente para usuarios de linux/unix.
java2exe (ahora JexePack) también permite generar .exe, pero es una aplicación de pago.
Algunos IDE, como JBuilder, también permiten generar el exe.
De todas formas, no he probado ninguno de ellos. De momento no tengo ninguna necesidad especial de generar .exe. Además, pienso que se pierde un poco la filosofía de java, que es que el "ejecutable" se pueda ejecutar en cualquier sistema operativo. Tampoco suelo hacer aplicaciones para usuarios no programadores.
27 julio 2006
Cambiar el icono de la taza de café en java
La forma normal de cambiar el icono de la taza de café en java en una aplicación consiste en llamar al método setIconImage() del JFrame principal de la aplicación. Luego, el resto de JDialog de la aplicación deben ser hijos, nietos o biznietos de este JFrame, heredando así su icono. Puedes ver más detalles de este cambio de icono.
Sin embargo, ayer un compañero de trabajo encontró una forma más bruta de hacerlo, de forma que queda cambiado para todas las aplicaciones java de nuestro ordenador (salvo que ellas lo cambien de forma expresa dentro).
Este método de fuerza bruta consiste en buscar dentro de nuestra instalación de java los ficheros rt.jar y awt.dll, que contienen dentro dicho icono de la taza de café y cambiarlo por otro. En Cambiar el icono de la taza de café están los detalles.
25 julio 2006
Dos programas opuestos
Aquí un par de programitas para java que pueden ser más o menos útiles y que sirven para lo contrario.
El primero es un "descompilador" de java. El DJ Java Decompiler es un programita que dándole los ficheros .class es capaz de sacarnos los fuentes .java. Tiene interface gráfica y es gratis.
El otro programa, en realidad son varios, son los ofuscadores de código java. Precisamente para evitar que nuestros programas java puedan ser "descompilados", existen estos ofuscadores. Básicamente lo que hacen es cambiar los nombres de clases, métodos y variables por nombres crípticos. El programa .class puedes descompilarse igualmente, pero no es lo mismo intuir que el método setNombre(String nombre) de la clase Persona mete el nombre de la persona en la clase Persona, que intuir qué demonios hace afaewser(String afew) de la clase Xdañsiñwe. Supuestamente, además de ofuscar y ya puestos a tocar el jar, la mayoría de ellos llevan a cabo labores de optimización, tratando de reducir el jar lo máximo posible, eliminando código innecesario, variables no usadas, métodos no usados, etc. De hecho, la ofuscación de código es más bien un "efecto secundario" de este proceso. Para reducir el tamaño del jar, no hay nada como llamar a las clases, métodos y variables con nombres lo más cortos posibles. No he probado ninguno, pero por lo que he leido es lo que intuyo que hacen...
ProGuard es un ofuscador gratuito y en la misma página tienes un listado de otros ofuscadores de código.
21 julio 2006
Método toString() de Element de org.w3c.dom
Me he tropezado con un pequeño problemilla que cuento aquí por si a alguien más le pasa lo mismo.
Resulta que trabajando con la versión 1.4 de java, cuando tengo un Document correspondiente a un fichero xml guardado en memoria, haciendo toString() del Element raiz del Document, me devuelve un String con el contenido del fichero xml.
Sin embargo, ¡sorpresa!, en la versión 1.5 de java este método toString() ya no devuelve el String el formato xml, sino que devuelve una cosa rara, cortita, que no vale.
En Bug ID: 6181019 REGRESSION: org.w3c.dom.Element.toString() no longer returns the xml document: "toString" está comentado este problema con más detalle.
Contar líneas de código
Hay una cosa que descubrí hace ya bastante tiempo, pero que me llamó mucho la atención por su simplicidad, y es el cómo se pueden contar las líneas de código de un programa de una forma simple.
En su momento, cuando me ví en la necesidad de contar las líneas de código que habíamos hecho en el trabajo, y de esto hace mucho y no había las herramientas que hay ahora o, al menos, no se encontraban de forma gratuita en la red, me puse a pensar en ello y buscar por internet.
Lo de contar líneas tal cual (contar retornos de carro) me parecía poco fiable. Si alguien deja muchas líneas en blanco, no hace muchas líneas de código, pero se cuentan como tales. Los comentarios también contarían como líneas de código. Si alguien abre las llaves "{" en una nueva línea
public void funcion ()
{
...
hace más líneas de código que uno que lo pone todo seguido
public void funcion () {
...
Investigando por internet, encontré la forma muy aproximada y sencilla de hacerlo. ¡¡Basta con contar los punto y coma ";" del código!!
Como cada línea de código acaba en punto y coma (En C, C++, java y otros muchos lenguajes) esto nos da una aproximación muy buena y simple del número de líneas de código.
Además, si alguien es vago como yo y no quiere demasiada precisión en la medida, basta con encadenar unos comandos de unix/linux para contar algo parecido al número de puntos y coma
$ cat `find . -name *.java` | egrep ";" | wc -l
La primera parte saca un listado por pantalla (cat) de todos los ficheros .java que encuentre del directorio actual hacia abajo.
La segunda parte, filtra (egrep) para que en el listado sólo salgan las líneas que contienen al menos un punto y coma.
La tercera parte, cuenta (wc) las líneas del listado anterior.
El resultado es el número total de líneas de los ficheros .java que contienen al menos un punto y coma, es decir, una aproximación más o menos buena del número de líneas de código.
De todas formas, alguien que sepa un poco más de linux seguro que encuentra la forma de contar el número de ; de una forma también sencilla ...
Tutorial C y C++ , Programación de sockets con C y linux
Veo en Tutorial C y C++ , Programación de sockets con C y linux que han puesto uno de mis tutoriales en un marco y justo encima han puesto una cabecera de ellos.
El marco es directamente mi página, no es una copia, y en la cabecera ponen la página original. En fin, me parece todo bien y correcto, pero me ha llamado mucho la atención el verlo ...
El marco es directamente mi página, no es una copia, y en la cabecera ponen la página original. En fin, me parece todo bien y correcto, pero me ha llamado mucho la atención el verlo ...
17 julio 2006
El PageRank de google está cabra
Acabo de ver que después de cuatro meses de mis apuntes de programación. por fin tiene un PageRank. Le dieron uno de cero al poco de crear la página/dominio. Ahora tiene uno de 4, que es más o menos lo que tenía mi antigua página www.geocities.com/chuidiang.
Sin embargo, veo que el page rank actual está un poco tonto.
Mi diario de correr y bicicleta tiene un pagerank de 3. Si miro, según google, las páginas que enlazan a él, no hay ninguna. Tampoco tiene apenas visitas. Sin embargo, este diario de programación tiene sólo un pagerank de 2. Hay varias páginas que enlazan a él (según google) aparte de la mía y además tiene unas cuantas visitas diarias.
¿Cómo es posible esto?.
También hay otro mito que no sé si es real. Supuestamente con un pagerank más elevado tus páginas salen más arriba en los buscadores. Sin embargo, desde que mis apuntes de programación han pasado de pagerank 0 a pakerank 4 (el viernes o el sábado pasado), no he notado ningún cambio en el número de visitas.
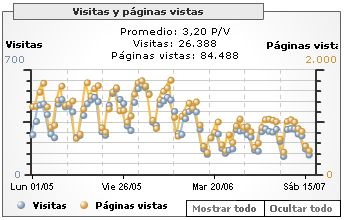
Sin embargo, de vez en cuando sí noto cambios bruscos que duran temporadas largas de vez en cuando. Por ejemplo, el número de visitas se ha reducido casi a la mitad, de forma progresiva, desde mediados de Junio sin razón aparente (ver gráfico).
Sin embargo, veo que el page rank actual está un poco tonto.
Mi diario de correr y bicicleta tiene un pagerank de 3. Si miro, según google, las páginas que enlazan a él, no hay ninguna. Tampoco tiene apenas visitas. Sin embargo, este diario de programación tiene sólo un pagerank de 2. Hay varias páginas que enlazan a él (según google) aparte de la mía y además tiene unas cuantas visitas diarias.
¿Cómo es posible esto?.
También hay otro mito que no sé si es real. Supuestamente con un pagerank más elevado tus páginas salen más arriba en los buscadores. Sin embargo, desde que mis apuntes de programación han pasado de pagerank 0 a pakerank 4 (el viernes o el sábado pasado), no he notado ningún cambio en el número de visitas.
Sin embargo, de vez en cuando sí noto cambios bruscos que duran temporadas largas de vez en cuando. Por ejemplo, el número de visitas se ha reducido casi a la mitad, de forma progresiva, desde mediados de Junio sin razón aparente (ver gráfico).

13 julio 2006
Ficheros KK
En todo proyecto informático que se precie hay uno o más ficheros "kk", que no sirven para nada, que nadie usa, pero que si se te ocurre borrar el proyecto deja de funcionar.
También suele haber varias versiones de ejecutable, cuyos ficheros se llaman así ejecutable_bueno.exe, ejecutable_nuevo.exe, ejecutable_hoy.exe, ejecutable_ultimo.exe. Está claro que esta nomenclatura de nombres es la más adecuada para saber cual es el que hay que arrancar, en función de que se quiera el bueno, el nuevo, el de hoy o el último.
También suele haber varias versiones antiguas, etiquetads ejecutable_antiguo.exe, ejecutable.exe.bak, ejecutable.exe.old, ejecutable_viejo.exe. De esta forma también es fácil saber qué se debe recuperar, según se quiera el old, el viejo, el bak o el antiguo.
Rizando el rizo, a veces también hay líneas de código que nunca se llaman, ni poniendo un breakpoint con el debugger en ellas, ni System.out, ni printf, ni de ninguna manera, pero ¡Ay de tí como se te ocurra borrarlas!. El ejecutable dejará de funcionar.
07 julio 2006
Más sobre el patrón Decorador
Acabo de terminar mi primer cacho de programa usando el patrón Decorador como comenté en el post anterior.
Una primera ventaja que le veo, en mi caso concreto, es que puedo hacer todo el código sin necesidad de la base de datos y probarlo. Mi modelo de datos va en memoria implementando una interface, mis clases de ventanas y demás sólo ven la interface. Mis clases de mis librerías reutilizables sólo ven la interface, así que puedo usarlas tal cual sin tocar nada en ellas, sin necesidad de hererdar ni de configurarlas de ninguna manera.
Luego, hago el decorador del modelo que se encarga de la base de datos. Dentro de él meto el modelo de datos e implemento todos los métodos simplemente para que se redirijan al modelo interno. Con esto todo sigue funcionando igual que antes, sin base de datos.
Ahora sólo me queda, poco a poco, ir modificando los métodos del decorador para que hagan su trabajo en la base de datos.
Otra ventaja adicional que le veo es que todo lo de base de datos (las sql, la conexion, etc, etc) queda encapsulado en una única clase.
La verdad es que la experiencia me ha gustado bastante y pienso repetir en adelante.
05 julio 2006
Posibilidad para el patrón Decorador
Estoy experimentando con el patrón Decorador y de momento parece que tiene buena pinta.
Me explico. Es bastante habitual que tenga que hacer alguna aplicación con unas ventanas para mostrar datos recogidos de una base de datos. Desde dichas ventanas debe además poder modificarse los datos en base de datos. Los típicos añadir, borrar y editar.
Mi forma habitual de hacer esto era con el patrón Observador. Hago una clase que llamo modelo de datos en la que guardo los datos de la base de datos después de haberlos leido. A esta clase le pongo un mecanismo de suscripción, de forma que otras clases puedan enterarse cuando se modifican los datos.
Hago otra clase que se encarga de leer la base de datos y rellenar el modelo de datos. Tiene además los métodos para añadir, modificar y borrar elementos de base de datos.
Las ventanas son clases que están suscritas al modelo de datos, de forma que cuando el modelo de datos se rellena de datos, automáticamente las ventanas los muestran. Algo similar al DefaultTableModel de java y el JTable.
Los botones de las ventanas que permiten modificar los datos los suelo hacer que actuen directamente con la clase que se encarga de la base de datos. Si unos de estos botones debe añadir, borrar o modificar algo, lo hace contra la clase de base de datos. Esta se encarga de hacer la modificación en base de datos y si tiene exito, refleja el cambio en el modelo. Este a su vez por medio del patrón observador avisa a la ventana para que refleje el cambio.
Todo este es el mecanismo que uso habitualmente, pero no me acaba de convencer porque acaba todo entremezclado. Los botones, que son interface de usuario, deben ver a la clase de base de datos y esta a su vez ve al modelo de datos. Tengo botones ya hechos que hacen las tareas habituales de añadir, borrar y modificar elementos de una lista, pero siempre tengo que heredar de ellos o instanciarlos pasándoles la clase de base de datos y "capando" su comportamiento de actuar sobre le modelo directamente.
Ahora estoy intentando aplicar el patrón Decorador. Consiste básicamente en hacer que la clase de modelo de datos y la clase de base de datos cumplan la misma interface y puedan intercambiarse. Ambas tienen métodos añade(), borra() y modifica(). La clase de base de datos además admite que se le pase el modelo de datos.
El método añadir(), por ejemplo, en la clase de base de datos, inserta en base de datos y si la inserción tiene éxito, llama al añadir() del modelo de datos.
Tanto el modelo de datos como la clase de base de datos implementan un patrón observador, para notificar cambios en los datos. La de modelo de datos es normal. La clase de base de datos se suscribe al modelo de datos y notifica cuando notifique este. De esta forma, cuando la clase de base de datos añade() un dato, lo mete en base de datos y luego en el modelo. El modelo avisa a la clase de base de datos y esta a sus suscriptores, que serán las ventanas.
Al hacer que ambas clases implementen la misma interface, a las ventanas puedo pasarles indistintamente una u otra. Las ventanas y los botones actuarían directamente sobre la interface, con lo que no saben si lo están haciendo contra base de datos o contra el modelo de datos. Las ventanas se refrescarán también correctamente independientemente de qué modelo se les pase.
Esto tiene otra ventaja adicional, y es en el borrado. Habitualmente los modelos de java como TableModel, avisan del borrado después de haber borrado. Con mi antiguo mecanismo de suscripción, no podía obtener el elemento borrado para borraren la base de datos, únicamente sabía qué fila se había borrado, pero no podía obtener el elemento borrado, ni su clave en la base de datos. Con este nuevo mecanismo de patrón Decorador, me avisan cuando se quiere borrar, con lo que puedo borrar de base de datos, luego del modelo y luego se refresca la vista.
En fin, lo poco que voy probando va teniendo buena pinta y muchas ventajas respecto a mi antiguo mecanismo. En algún momento haré un pequeño tutorial para mi página en la que se haga una tabla con añadir, borrar y modificar de una base de datos usando este patrón.
29 junio 2006
Echo de menos programar mal
Últimamente ando un poco deprimido con esto de la programación. Llevo muchos años programando y mi forma de programar ha ido evolucionando mucho, se supone que para mejor.
Al principio hacía mi código rápido. Mis clases eran gigantes y muy poco reutilizables. Apenas usaba herencias, prácticamente nunca el polimorfismo y nunca había oido hablar de patrones de diseño. Mi objetivo era hacer el código rápido y que funcionara.
Luego aprendí a usar el polimorfismo, leí sobre patrones, las clases deben ser pequeñas, el código debe ser reutilizable, hay que comentar, etc, etc.
Ahora programa tratando de seguir todas estas cosas. Cualquier programa que hago se llena de clases separaditas, algunas de ellas siempre acabo reusándolas en otro sitio. Me llevo clases de estas a "librerías" que clases para usar en otrs proyectos. Mi código tira mucho de esas "librerías" que me he ido haciendo con el tiempo. Uso los patrones, el polimorfismo. Supuestamente, todo lo más mejor que soy capaz de hacerlo.
Sin embargo, hecho de menos los viejos tiempos. Antes programar era divertido. Ahora se convierte casi en una tortura. Cuando hago algo o modifico algo hecho, tengo que emepezar a revisar las clases de las librerías, soy incapaz de hacer algo una clase grande o un método largo, así que hago muchas clases y métodos. Cuando una cosa parece que puede ser reutilizable más adelante, la hago un poco mejor para llevármela a la librería, etc, etc.
Para un mismo programa, ahora hago muchísmimas menos líneas de código, pero echo bastate tiempo en pensarlas, rebuscar por la librerías, por las clases ya hechas, pasando de una interface a la clase que la implementa que simplemente acaba llamando a un método de otra clase que a su vez...
Echo de menos los tiempos en que programar era liarse a echar lineas de código sin más, aunque no fuera la forma más eficiente.
28 junio 2006
maven
En el trabajo ya he metido un par de proyectos con maven.
Con el tiempo hemos desarrollado varias librerías en java. Una de comunicaciones (sockets y rmi), otra con algoritmos matemáticos, otra con componentes de interface de usuario, para ventanitas con acceso a base de datos, etc, etc.
He creado proyectos maven para los fuentes de cada una de estas librerías. En un servidor he montado un repositorio de jar accesible para todo el mundo a través de ftp. Con maven, he compilado estas librerías y metido los jar en el respositorio común.
En dos proyectos que están ahora en marcha, los he modificado para que funcionen con maven. He puesto las dependencias correspondientes a log4j y demás librerías standard, además de las dependencias de nuestras librerías propias. Todo ha funcionado correctamente. Al compilar por primera vez estos proyectos con maven, se ha ido a internet y a mi repositorio de jars a buscar las librerías indicadas, se las ha descargado y todo bien.
Me quedan sin embargo dos pequeñas pegas que solucionaré jugando un poco.
Por un lado, si modifico un jar dentro del repositorio de jars, no sé si los proyectos que lo utilizan se enteran y se bajan la nueva versión (a la que no he numerado como nueva versión). Creo que poniendo lo que maven llama versión SNAPSHOT, sí lo haría. De todas formas, la primera prueba que he hecho con esto no me acaba de convencer.
Por otro lado, todo el tema de integración con los IDE. Maven tiene estos comandos
mvn idea:idea
mvn eclipse:eclipse
que generan los proyectos para Idea y para eclipse. Para el primero funciona todo perfecto. Sin embargo, para eclipse parace que el tema funciona peor. No me gusta cómo se monta el proyecto en eclipse, sobre todo si es un proyecto maven con subproyectos debajo.
Hay además un plugin de eclipse para poder utilizar maven desde el ide. Lo he instalado una vez y me ha ido bien, pero ya no puedo tocar en dependencias el proyecto como a mi me gustaría. Un compañero mio ha instalado el mismo plugin y no ha podido volver a abrir eclipse. Le da un error en el inicio, antes de abrir nada y de ahí no sale, ni desinstalando el plugin a mano (borrándolo del directorio plugins).
En fin, con eclipse parece que ese plugin no es buena cosa, aunque seguiré en ello.
14 junio 2006
Foro de Java y C++ de Chuidiang
Tengo el foro Foro de Java y C++ de Chuidiang abandonado.
En el trabajo, resulta que tenemos un corta fuegos que no permite acceso a través de un montón de puertos y además el proxy nos prohibe el acceso a determinadas páginas. ¡Sorpresa!. Desde este Lunes está prohibido el acceso al foro (supongo que la prohibición es a foroswebgratis).
En casa, por problemas técnicos que no vienen al caso, estoy sin internet.
Resultado: No puedo ni siquiera ver qué hay en mi propio foro y tampoco puedo actualizar mi página web.
Espero que los problemas técnicos caseros se resulevan pronto....
Problemas de refresco con internet explorer
Uno de los motivos de mi cabreo con css eran los problemas de refresco que se me plantean en mi página de apuntes de programación cuando se mira con internet explorer.
Si visualizamos la página y ponemos una ventana encima o jugamos con el scroll de una forma "brusca", desaparecen algunas letras o incluso se quedan a medio dibujar.
Jugando ayer, ya tengo una pista del problema. Las líneas que desaparecen es justo encima de los anuncios de google o del buscador de google. Parece entonces que hay algo en los javascript de google que no le gusta al internet explorer. Todavía no he conseguido arreglarlo, pero teniendo la pista ya parece más fácil o, al menos, "ñapeable".
Sin embargo es curioso porque sólo pasa en aquellas páginas que he "modernizado" hace poco con css, dándoles el aspecto de libreta con papel rayado. En las antiguas páginas no pasa. Habrá que seguir investigando un poco.
13 junio 2006
Cascading Style Sheets, Level 2
Dados mis problemas con css, buscando, encotré esto Cascading Style Sheets, Level 2 que supongo que es donde tenía que haber ido desde el principio. Tiene buena pinta salvo que está en un idioma extraño.
Curiosamente, es de la página que me aconsejaba JJR en un comentario de un post anterior.
Curiosamente, es de la página que me aconsejaba JJR en un comentario de un post anterior.
12 junio 2006
Free Java Books
Aunque estén en perfecto inglés, en Free Java Books hay un montón de libros gratis para bajarse sobre java. Están incluidos los de "thinking in java" y "thinking in patterns whith java".
10 junio 2006
Más css
Bueno, acabo de conseguir que se peguen los dos div. El truco es este:
<div>cosas<div>
<div>mas cosas<div>
Si lo hacemos así, sí salen pegados, pero si se nos ocurre hacer esto
<div>cosas</div>
<div><p>mas cosas</p></div>
entonces se separan. Si en vez de <p> es un <h1;> también se separan.
Aparentemente p o h1 tienen un márgen. El div se queda pegadito a la etiqueta p o h1, pero el margen de esa etiqueta cae fuera del div y es lo que hace que se separe del div anterior.
Los contenidos de cada "fila" de pixels serían esto...
div
margen superior de p o h1
otro div y contenido de p o h1
...
Bueno, creo que voy entendiendo cómo va el asunto. A ver si encuentro algún tutorial en castellano que explique cómo son las cosas (la filosofía de css) en vez de limitarse a poner etiquetas explicadas una detrás de otra.
css, internet explorer y firefox una mierda
Bueno, estoy un poco cabreado, así que ahí voy a soltarlo todo.
No tengo ni idea de css, estoy empezando, pero desde luego lo que veo no me gusta nada.
En primer lugar, internet explorer y firefox no se comportan igual ante el mismo código, cada uno hace lo que le da la gana (se supone que firefox hace lo correcto), pero de todas formas hay que andar peleándose para ver si sale igual, o al menos decente, en ambos exploradores y andar "ñapeando" para que así sea.
Luego, con firefox veo cosas que no me cuadran. Intento conseguir que dos div salgan pegados. No hay manera. En algunas de mis páginas sí salen pegados, en otras no y aparentenmente hay lo mismo (ambas incluyen el mismo fichero css y los div están colocados exactamente igual). Seguro que la diferencia es algo que hay dentro del div, pero no logro acertar con qué es. Sin embargo, en el que no lo cosigo, si al div de abajo le pongo un borde solid de 1px entonces misteriosamente se mueve y se pega. Si le pongo 0px vuelve a salir separado. ¿Será que el borde por defecto es de varios pixels? ¿Y si no quiero borde en absoluto? ¿Por qué en otras páginas me sale bien sin necesidad de poner el borde?.
La última mierda: Mi página inicial, por ejemplo, sale bien en internet explorer y firefox, pero me da problemas de refresco en internet explorer. Si se abre una ventana encima y se cierra o se juega con el scroll, desaparecen letras o quedan incluso a medio pintar.
No dudo que con esfuerzo y aprendiendo trucos se puede conseguir que salga bien en todos lados pero ... ¿qué interés tiene para mí echar horas y horas en eso para resolver problemas de los navegadores?.
Voy a seguir un poco más, pero al final creo que pasaré de css y seguiré haciendo mis páginas cutre-simples html y ya. Al final, para poner tutoriales no necesito grandes presentaciones.
05 junio 2006
PMD y eclipse
PMD es un programa para revisar métricas de nuestro código. Puedes bajártelo como aplicación independiente en http://pmd.sourceforge.net/ y tiene plugings para un montón de IDEs, incluido Maven.
Me bajé la versión 3.1.5 y la instalé con eclipse 3.1.2, pero todo son problemas. Según le das la primera vez para que analize las métricas va bien y saca más métricas no adecuadas de las que me gustaría.
Sin embargo, según voy trabajando y le doy a que repase las métricas, incluso de un sólo fichero, se me queda colgado, tarda un montón y me deja el eclipse más pallá que pacá.
Al final, voy a desinstalar el plugin este y probaré con maven a ver qué tal va...
03 junio 2006
Guestbook
Cuando cogí el dominio y después de jugar un poco con las herramientas que me daban, instale un libro de visitasGuestbook, el Viper GuestBook.
Aunque la última versión parece que viene protegida para que no se pueda meter basura alegremente (mensajes de esos que sólo tienen links) y que suelen meter "robots", yo tengo anterior que no tiene esa protección.
De momento lo he solucionado añadiendo un nuevo campo en el que pido una suma y restrinjo las posibles entradas del campo sólo al resultado correcto de esa suma. Aunque es un poco chapuza, de momento parece que funciona y no tengo más problemas.
Tendré que escribir a los de hostito a ver si piensan actualizarlo, o bien descargarme la versión más moderna e instalármela yo por mi cuenta.
Más sobre apache y php
Como últimamente ando metiendo algo de php y jugando con css para mi página web, me he decido a instalar también en casa apache y php. De esta forma podré ver el resultado de mis páginas antes de subirlas al servidor.
Me bajé la última de Apache (2.2.2) y la de PHP (5.1.4) y me puse a ello. Igual que en el trabajo, tuve el problema de "cannot load php5apache2.dll into server". Como en el trabajo, después de un día de pelearme con ello, conseguí arreglarlo reemplazando la librería php5apache2.dll por otra, voy a ello directamente al grano.... ¡No funciona!. En casa esa solución no me vale.
Vuelta a indagar por internet y al final seguí un sabio consejo que encontré por ahí. Instalar versiones más antiguas. Instalé dos versiones que tenía en el ordenador de otra vez que intenté todo esto: apache 2.0.53 y php 5.0.3. Funcionó todo perfecto y a la primera.
A veces no es bueno irse rápidamente a la última versión de algo.
01 junio 2006
Javolution
Un compañero de trabajo ha encontrado esto Javolution. Una especie de añadido a java con clases muy rápidas para tiempo real.
Bueno, es otra cosa más que hay que probar un día de estos.
Bueno, es otra cosa más que hay que probar un día de estos.
elmundo.es - Lo que Google sabe de mí
Un compañero de trabajo me ha mandado esta noticia elmundo.es - Lo que Google sabe de mí.
Realmente da qué pensar.
Realmente da qué pensar.
php5 y apache2 en windows
Después de la gracia de tener que reinstalar windows, me decidí a volver a poner apache/php/mysql en windows. Ya puestos, me bajé las últimas versiones de todo.
Al instalar apache 2.2 con php 5.1.4 he tenido un problema: no había forma de que funcionara. Por más que revisé que todo estaba correcto, al arrancar el servidor apache siempre obtenía el error
Cannot load c:/php/php5apache2.dll into server
Buscando por internet, al final encontré que es un pequeño problema de compatibilidad entre apache 2.2 y php 5.1.4. Hay versiones de apache ya compiladas que no pueden cargar este modulo. Encontré esa información aquí http://www.webestilo.com/foros/mensaje.phtml?foro=3&msg=43520&pag=
La solución que propnen ahí es bajarse una nueva php5apache2.dll de aquí http://www.apachelounge.com/download/ y reemplazarla por la original.
Lo he probado y efectivamente funciona.
Bueno, ahora me queda la parte de mysql ...
31 mayo 2006
ResultSetMetaData
En su día, cuando me lie con java y base de datos, descubrí la clase ResultSetMetaData. Con esta clase podemos desde código conocer qué datos hay dentro de un ResultSet, sin necesidad de saberlo a priori en el momento de programar.
Gracias a esta clase, podemos hacer código muy genérico para meter los datos de una consulta en un JTable.
Acabo de meter un pequeño tutorial para introducir al uso del ResultSetMetaData. De paso, en el código de ejemplo del tutorial, se hace una clase genérica que permite meter cualquier ResultSet en un JTable usando el ResultSetMetaData.
La única pega es que el nombre para la cabecera de la tabla es la etiqueta que se defina en la base de datos. Es posible que algunas bases de datos no permitan poner una etiqueta distinta del nombre del campo en la tabla. En estos casos es necesario hacer algún arreglo en la clase genérica para que admite qué textos se quiere mostrar al usuario como etiquetas de cabecera en la tabla.
Websites as graphs - an HTML DOM Visualizer Applet
Otro invento curiosísimo que me acabo de encontrar: Websites as graphs - an HTML DOM Visualizer Applet
Metes una página web y te saca una especie de árbol en el que están los tags de esas páginas. Aparte de probar alguna, puedes ver fotos de flirck con algunos ejemplos que son realmente curiosos.
No sé si tiene utilidad, pero al menos es entretenido. Se necesita tener instalado java.
Hay más versiones de lo mismo:
http://www.texone.org/tree/tree.php?id=applet
http://a.parsons.edu/%7Echristine/fall_03/organic_html/flash/main.html
del.icio.us
Aunque hace tiempo que lo conozco, hasta hace poco no le había prestado atención. En del.icio.us te puedes dar de alta y puedes añadir tus páginas favoritas. Tiene varias ventajas respecto a añadirlas directamente en el navegador:
- Las tienes accesibles desde cualquier ordenador. Además, ahora que ando precisamente sufriendo windows, no tengo riesgo de perderelos.
- Las organiza por etiquetas que tú pones, de forma que si yo busco por mi etiqueta "java", tendré todos los links que he añadido relativos a java.
- Permite ver cuánta gente que está dada de alta ha añadido esa misma página a sus favoritos. A mí, que tengo una página web o incluso este diario, me viene bien porque me dice si hay gente que ha añadido mi página o mi diario a sus favoritos. Basta con que yo la añada para ver si otros también la han añadido.
- Permite ver o compartir los links de otros usuarios, con lo que viendo usuarios con tus mismas aficiones, puedes ver sus links y descubrir páginas interesantes.
Otra cosa interesante es que hay un plug-in para firefox que te pone unos botoncitos en la barra de herramientas y permite añadir o ver directamente los favoritos sin necesidad de navegar a esta página.
Ahí teneis mis favoritos: http://del.icio.us/chuidiang
30 mayo 2006
Recuperar Windows
 Tengo dos ordenadores, uno en el trabajo y otro en casa, en el que en un momento dado he tenido problemas de arranque o de otras cosas. En ambos casos decidí coger el CD de windows 2000 y darle a la opción de "recuperar sistema" o de "reinstalar". En ambos casos respeta de alguna forma lo que hay y reinstala windows.
El caso es que ahora tengo dos ordenadores que van bastante mal. En ninguno de ellos funciona el windows update, siempre acaba dando error. Los programas, aunque los reinstale, hace cosas raras. Por ejemplo, apache se queda colgado casi al final de la instalación. Firefox no puede meter favoritos en marcadores ni recuerda el tamaño de la última vez que se abrió. Y así infinidad de detalles.
El caso es que la opción esta de recuperar-reinstalar parece que es una chapuza. Al final es mejor, si se tiene opción, hacer backup de todo lo que se tiene de interés e instalar windows formateando el disco duro. Si no se formatea, windows respeta lo existente y tenemos problemas.
27 mayo 2006
Es increible lo que nos depara el futuro
Hace tiempo que vi este video, pero ahora lo he encontrado en YouTube.
Una pantalla táctil en la que se hacen verdaderas maravillas. A ver lo que falta para que lleguemos a tener eso en nuestras casas.
Una pantalla táctil en la que se hacen verdaderas maravillas. A ver lo que falta para que lleguemos a tener eso en nuestras casas.
26 mayo 2006
Atender a varios clientes con hilos
Me puse con un tutorial para ver cómo atender varios clientes a la vez en java usando sockets e hilos. Como al final resulta que es una tontería, me decidí a hacer un ejemplo un poco más complejo de lo habitual, un chat en java.
Bueno, el chat no es ninguna maravilla, pero el la base para un chat un poco mejor. Necesita cosas como:
Bueno, el chat no es ninguna maravilla, pero el la base para un chat un poco mejor. Necesita cosas como:
- Que el cliente busque al servidor en algún sitio que no sea el "localhost". Supongo que tendría que pedirlo al usuario antes de conectarse.
- Debería pedir también un mote (nick dicen los ingleses) para identificar quién dice qué.
- Según va apareciendo texto, la barra de scroll no se desplaza automáticamente para ver el nuevo texto. Habría que arreglarlo.
- En el servidor habría que sincronizar el acceso a los datos. Aunque he puesto un synchronized, no me he preocupado de verificar si hace falta en más sitios.
- No he controlado el tema de las desconexiones. Si un cliente cierra el programa, no he probado qué pasa en el servidor, pero posiblemente salte alguna excepción.
Herramientas a mogollón
Como comentaba hoy con unos compañeros de trabajo, es una pena que tengamos que dedicarnos a los proyectos del cliente en vez de a investigar todo lo que hay por internet.
Leyendo un diario he descubierto que existe subversion. Es como CVS, pero se supone que lo mejora y está empezando a oirse más de él. El servidor de subversion se integra además si se quiere con un servidor apache. También hay plug-ins para eclipse, el subclipse.
También acabo de descubrir bugzilla. Es una especie de cosa que a través del navegador y supongo que contra una base de datos permite que la gente meta incidencias (o bugs) y se lleva un registro de ellos. Se pueden corregir, etc, etc. Lo usan gente como los de mozilla o eclipse. Sin embargo, además de un uso web, le veo una buena aplicación en el trabajo. A veces los sitios donde se prueban los proyectos están dentro de la empresa y en red, pero alejados de lso puestos de trabajo. Es una forma de llevar las incidencias de una forma centralizada. Según se prueba el proyecto, se van escribiendo las incidencias.
Otra del mismo estilo de bugzilla es Eventum, de los mismos de MySQL.
Tengo intención de probar Subersion y ver qué tal se integra con eclipse. En cuanto a las otras dos, les echaré un ojo a ver cual es más sencilla para los "usuarios". Si las veo demasiado completas, habrá que ir a algo más sencillo como phpticket, que no sé si es lo mismo estrictamente hablando, pero seguro que sirve para lo mismo.
25 mayo 2006
Maven
Hace tiempo, a petición del jefe, hice unos experimentos con maven para ver qué tal iba. En un par de días de prueba no me hice idea de si sirve para algo, pero creo que voy a ponerlo en algún proyecto para hacer una prueba más seria.
Esta mañana lo instalé nuevamente en windows. En instalación de maven hice un resumen de lo que fuí haciendo, aunque realmente no merece la pena porque es muy sencillo. Al hacerlo por segunda vez, lo hice más rápido y con menos problemas.
La primera pega que se me presentó la otra vez era el proxy de la empresa. Maven accede a internet para bajarse módulos y fichero .jar según los vamos necesitando. Había que configurar maven para que supiera cómo acceder y facilitara el nombre de usuario (el mio) y password de acceso al proxy. Como ya me peleé con ello la otra vez, esta vez fué rápida la configuración. Puedes ver lo que hay que tocar en el resumen que hice.
El siguiente problema que se me presentó al compilar con maven un proyecto grande de unas 3000 clases java, es que me daba un OutOfMemory. Buscando por internet encontré que poniendo la variable de entorno MAVEN_OPTS=-Xmx512m (opción para la máquina virtual de java) se arreglaba el problema y así fué.
El problema que tengo ahora es que maven por defecto compila con la versión 1.3 de java, aunque tengo instalada la 1.5. He visto por ahí que en un fichero de propiedades con un nombre adecuado y colocado en un sitio estratégico, se puede decir a maven con qué versión de java debe compilar. Mañana lo probaré.
24 mayo 2006
Applet de ejemplo de un paint en java
Una cosilla que hace tiempo que tenía ganas de hacer, una especie de paint brush estilo windows en java. Por supuesto, está algo más cutre, pero por fín lo he hecho.
Applet de ejemplo de un paint en java
Me llama la atención lo fácilmente ampliables que se pueden hacer las cosas con la orientación a objetos. Sin preocuparme demasiado de ello, pero si de no repetir código, se llega a una cosa que con poco esfuerzo más se puede ampliar mucho más.
Applet de ejemplo de un paint en java
Me llama la atención lo fácilmente ampliables que se pueden hacer las cosas con la orientación a objetos. Sin preocuparme demasiado de ello, pero si de no repetir código, se llega a una cosa que con poco esfuerzo más se puede ampliar mucho más.
Eufemismos cacofónicos
En mi empresa sueltan una especie de curso-charla-jornada de "Hacia la madurez en la organización de desarrollo". También se hacen "Evaluaciones del desarrollo del desempeño" y gracias a esasa cosas gana premios a la "excelencia empresarial".
Pero aquí seguimos currando todos apretados los unos con los otros, con cortes frecuentes de luz, ordenadores obsoletos que heredamos de los jefes que se compran portátiles nuevos para poder ver el word.doc que les manda la secretaria. Eso sí, todo de forma "excelente".
Al último curso al que me obligaron a ir, casi todo fuera de horario laboral por supuesto, era un módulo de "Programa de Gestión avanzada". Ahí, entre otros pasatiempos, hicimos grupos para hacer avioncitos de papel. Luego salimos al pasillo para probar cada grupo sus prototipos y finalmente una competición con el mejor prototipo de cada grupo para ver cuál llegaba más lejos.
La última fue un cartón satinado y multicolorín con el que se pretendía que hicieramos una pajarita, a la que podiamos dedicar un tiempo de un cuarto de hora, y se repartio a todos los empleados. No servía para nada (era propaganda para otro curso de estos cacofónico) y nos la dieron justo unos días antes de comunicarnos nuestra mini-casi-negativa subida de sueldo.
En fin, da gusto ver como hoy día a la gente se le llena la boca con palabras...
Otro fondo de escritorio
Esta otro es otro fondo de escritorio que me gustó mucho. Se llama "Barriendo el caos" y lo saqué de 20minutos.


23 mayo 2006
Visor de HTML en java
En mi página de apuntes de programación acabo de añadir un pequeño componente java que permite visualizar ficheros html. En el applet de ejemplo correspondiente he puesto una especie de mini-navegador sencillo.
Creo que lo próximo será un Canvas que haga de base para un paint estilo windows, que permita pintar lineas de colores arrastrando con el ratón...
Creo que lo próximo será un Canvas que haga de base para un paint estilo windows, que permita pintar lineas de colores arrastrando con el ratón...
22 mayo 2006
El test del disparate | Kriptópolis
Aquí hay una compartiva entre "delitos" de pirateo y "delitos" habituales El test del disparate | Kriptópolis.
Está claro que el que tiene "enchufe", tiene "enchufe" y le hacen las leyes a medida.
Está claro que el que tiene "enchufe", tiene "enchufe" y le hacen las leyes a medida.
20 mayo 2006
Manual ejemplos sencillos de programación avanzada c/linux gratis online
Me hacen gracia los de e-magister, que anuncian mi página web como Manual ejemplos sencillos de programación avanzada c/linux gratis online, hay que suscribirse a ellos para que puedan acceder a través de ellos a mi antigua página.
No recuerdo que hayan establecido contacto conmigo para comentármelo, ver si me parece bien, etc. Simplemente lo han hecho. Bueno, es otra forma más de que traigan visitas al sitio. También me sirve para ver opiniones de la gente sobre la página, aunque en alguna de ellas da la impresión de que la gente cree que la página es de e-magister.
No recuerdo que hayan establecido contacto conmigo para comentármelo, ver si me parece bien, etc. Simplemente lo han hecho. Bueno, es otra forma más de que traigan visitas al sitio. También me sirve para ver opiniones de la gente sobre la página, aunque en alguna de ellas da la impresión de que la gente cree que la página es de e-magister.
stu nicholls | CSS PLaY | experiments with cascading style sheets
Me he quedado alucinado con stu nicholls | CSS PLaY | experiments with cascading style sheets.
Antes pensaba que css era simplemente para cambiar los colorines y fuentes. Cuando me metí un poco más en serio, vi que era una potente herramienta para colocar las cosas en su sitio, hacer columnas, menús laterales, etc, etc. Además, se podía cambiar la posición fácilmente, por lo que dar distintos aspectos a la misma página es bastante fácil (es un decir, hay que currarselo).
Sin embargo, esta página que menciono me ha dejado alucinado. Convierte a css casi en un lenguaje de programación con un montón de posibilidades. Echadle simplemente un ojo por ejemplo al "gradient magnifier". Simplemente hay que pasar el ratón por la escala que hay encima de la foto.
También llama la atención el "css slide show". Basta con pasar el ratón por encima de "set 1", "set 2" o "set 3" y luego pinchar sobre una de las fotos que aparecen.
Va a haber que tomarse esto de css más en serio.
19 mayo 2006
Yahoo y Google
Desde hace mucho tiempo conozco la utilidad del buscador de google de ver qué páginas enlazan a una determinada. Por ejemplo, para ver qué páginas enlazan con la mia, tengo que poner en el buscador de google
link:http://www.chuidiang.com
Sin embargo, los resultados siempre me habían llamado la atención, incluso con mi antigua página de http://www.geocities.com/chuidiang, y es que no salían ni mucho menos todas las páginas que enlzaban con la mía. Además, el page rank de dichas páginas no tenía nada que ver, puesto que sí salían páginas con pagerank 0, mientras que no lo hacían otras con pagerank más elevado.
Acabo de leer en un blog que google elige los links que muestra y que no están todos los que están. Si queremos algo más detallado, menos escogido, tenemos la misma funcionalidad en yahoo, se hace exactamente igual y saca muchos más resultados.
Bueno, ya he encontrado una excusa para visitar yahoo de vez en cuando.
18 mayo 2006
google trends
Con google trends podemos ver unas estadísticas desde mediados del 2003 de las búsquedas en google.
Poniendo una palabra, nos saca un gráfico en el tiempo con el número de búsquedas en función del tiempo. También nos dice qué ciudades han buscado más esa palabra, qué paises y en qué idiomas.
Si ponemos varias palabras separadas por comas, nos saca al gráfico comparativo de ellas. Sólo por hacer la prueba, puse "asp, php, jsp" para ver qué busca más la gente. Este es el gráfico que obtuve (php arriba en naranja, asp en medio en rojo y jsp abajo, en azul). La parte de abajo son la aparición de estas palabras en las noticias.

En cuanto a paises, es curioso, porque donde más se buscan estas cosas son en países asiáticos (India y Corea los dos primeros). El primer no asiático sale en décima posición y es Colombia. Realmente inesperado. Hombre sabemos que chinos hay muchos y es posible que esto se busque más, aunque sólo sea por cantidad, en países asiáticos. Me sorprende algo más lo de Colombia...
sodaconstructor
Me acabo de encontrar en internet una cosa curiosísima, sodaconstructor. Es una especie de juego con el navegador en java 5 (necesitamos tener instalado java 5).
Construimos una especie de bicho a base de poner rectas y músculos. Decimos cómo queremos que se contraigan y estiren los músculos y vemos cómo se mueve el bicho.
Es todo a base de ratón y nada complicado de jugar, otro cantar es conseguir algo que se mueva con sentido.
Resulta muy curioso cargar los que tienen como ejemplo, hay bichos realmente llamativos, desde "gusanos" hasta uno que parece un camello de los del imperio contra-ataca, de la guerra de las galaxias.
QuantumDB Eclipse Plugin
QuantumDB Eclipse Plugin es un plugin para eclipse que nos permite conectarnos a una base de datos y manejarla. Podemos ver los datos, hacer updates, removes e inserts, etc, etc. Es una herramienta más que se integra con eclipse y nos permite depurar nuestros programas que trabajan contra base de datos, viendo sin salirse de la herramienta los resultados en la BD.
Se instala tan fácilmente como cualquier otro plugin de eclipse, basta con desempaquetar el zip correspondiente en el directorio de eclipse.
Luego, dentro del IDE; en "window", "open perspective", "other" nos aparece quantum. En esta nueva perspectiva podemos cargar drivers java de mysql, oracle o lo que queramos, luego añadir conexiones a una especie de lista de conexiones y desde ahí conectarnos o desconectarnos cuando lo consideremos oportuno.
Realmente cómodo para no tener que tener una aplicación separada y revisar la base de datos mientras desarrollamos.
Suscribirse a:
Entradas (Atom)

